离线回来,中间那段消息去哪了:飞享IM 会话断层的发现与补齐
comsince
FshareIM Team手机关机一个晚上,第二天打开飞享IM,群里已经聊了几十条。最新的消息都在,往上翻,翻着翻着就从今天早上直接跳到了昨天晚上,中间那一大段没了。这不是某一端的偶发 bug,Android、iOS、Web、PC 全都会出现。本文讲清楚这个问题是怎么产生的,我们为什么最终选择"服务端标出缺口、客户端按需补齐"的方案,以及在改动协议和四个客户端的同时,怎样把对现有用户的影响降到最低。
一、问题是怎么产生的
1. 一条为首次登录设计的限制
客户端上线后会发 MP 信令做增量拉取:带上本地记录的同步位置,服务端返回这之后的所有消息,同时返回新的 head,客户端把同步位置推进到 head。
服务端在打包这批消息时有一条限制:同一个会话最多下发最近 20 条,整批最多 3MB。这条限制的初衷很合理:新装 App 或换设备首次登录时,用户名下可能有成百上千个会话、几万条历史消息,一次全塞下来,首屏会非常慢。
问题在于,这条限制对增量拉取同样生效,而且截掉的消息没有任何记录:
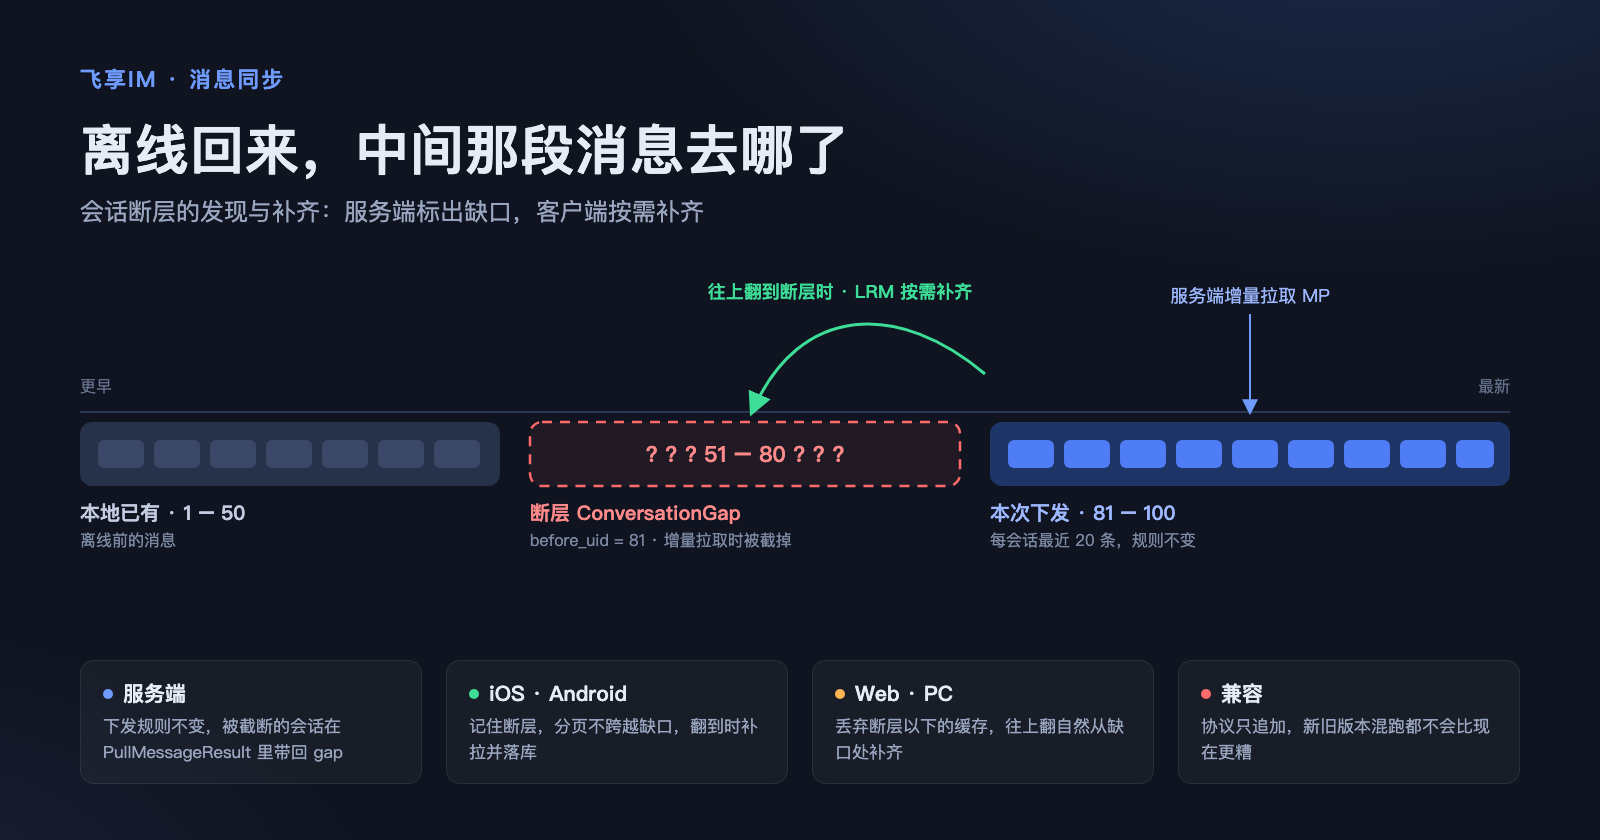
51~80 这 30 条被丢弃了,head 却已经推进到了 100。下次增量拉取从 100 之后开始,这 30 条再也不会出现在同步里。
2. 客户端"先本地、后远程"的翻页习惯
服务端其实提供了按会话往前翻的接口 LRM(loadRemoteMessages(beforeUid, count)),能拉到任意一段历史。但四个客户端的翻页逻辑都是:
- 先读本地缓存里更早的消息;
- 本地读完了,才用"本地最老一条"的 uid 去服务端拉。
对一个本地已经有 1~50 的会话来说,用户往上翻时,本地永远有更早的消息可读(50、49、48……),根本走不到第 2 步。于是 51~80 这段空洞就被本地的老消息"盖住"了:界面上看起来是连续的,实际上中间缺了一截。
3. 为什么客户端自己发现不了
消息的 uid 是服务端全局递增的雪花 ID,同一个会话里的 uid 并不连续(中间夹着其他会话的消息)。客户端看到本地有 50、新收到 81,无法判断 51~80 之间到底有没有属于这个会话的消息。缺口只有服务端知道,所以修复必须从服务端开始。
二、两种方案,以及怎么取舍
方案一:服务端不再截断增量拉取
最直接的思路:20 条限制只在首次登录(同步位置为 0)时生效,增量拉取一律全量下发;超过 3MB 就分页,客户端继续拉。
优点很明显:只改服务端就能修好,老客户端不用升级,部署完立刻见效。
但它有几个绕不过去的问题:
- 流量和首屏时间:离线一个周末、加了几个活跃大群的用户,上线时可能要一口气下载几千条消息。这些消息里的大部分,用户根本不会往上翻去看。
- 3MB 分页依赖客户端配合:现有客户端都直接用返回的
head推进同步位置,不会根据current < head继续拉。要让分页可靠,还是得改客户端。 - 违背首次登录限制的本意:那条限制本来就是为了控制"一次拉太多",增量拉取放开后,长时间离线和首次登录在体验上没有本质区别。
方案二:服务端标出缺口,客户端按需补齐
服务端保持现有下发规则不变,但在截断时告诉客户端缺口在哪;客户端记下这个缺口,用户真正往上翻到这里时,再用 LRM 按需补拉。
代价是要改协议,并且四个客户端都要实现补拉逻辑。
为什么选了方案二
我们权衡的核心是一个事实:IM 用户上线后,绝大多数时候只看每个会话最新的几十条。离线期间群里刷过的几百条消息,真正被翻到的只是一小部分。
| 维度 | 方案一 | 方案二 |
|---|---|---|
| 上线时流量 | 与离线期间消息量成正比 | 与现在一致(每会话 ≤ 20 条) |
| 上线首屏速度 | 长时间离线时明显变慢 | 不变 |
| 改动范围 | 主要在服务端,分页仍需客户端配合 | 协议 + 服务端 + 四端 |
| 老客户端 | 立即受益 | 行为不变,升级后受益 |
| 历史数据 | 已经丢的补不回来 | 已经丢的补不回来 |
方案二把"补齐"的成本推迟到用户真正需要的那一刻,上线这个高频路径完全不变。多出来的开发量是一次性的,而流量和首屏体验是每个用户每天都要面对的,这笔账算下来方案二更划算。
三、协议:只追加,不修改
PullMessageResult 追加一个 repeated 字段:
conversation取拉取者视角:单聊的 target 是对方,和客户端本地的会话键一致,客户端拿到就能直接用。before_uid是本次为这个会话下发的最老一条消息的 uid,含义是"比它更早的、属于本次同步区间的消息没有下发"。- 还有一种边界情况:3MB 上限把某个会话整个挤掉了,一条都没下发。这时
before_uid取 int64 最大值,我们称之为尾部断层:缺的不是中间一段,而是最新的一段。
WebSocket 链路(Web、PC)对应在 JSON 应答里加 gapList,beforeUid 用字符串表示,避免 JavaScript 丢失 64 位整数精度。
四、服务端:规则不变,只是不再"沉默"
改动集中在 push-group 的增量拉取打包逻辑。原来"按会话分组、每组保留 20 条、按 3MB 打包"的代码嵌在一个两百多行的方法里,和 Hazelcast 读写、群成员过滤混在一起,很难单独验证。这次把它抽成了一个纯函数类 PullMessagePacker:
- 输入:已经按 seq 排好、已经过滤掉聊天室和已退群消息的序列;
- 输出:要下发的消息 + 断层列表。
下发规则一条都没改:每会话 20 条、整批 3MB、会话的打包顺序,都和原来一致,单元测试里专门有一条用例守住"下发顺序和旧实现相同"。唯一的变化是:某个会话实际下发的条数少于本次遍历到的条数时,生成一个 gap。
顺带修正了一个隐患:原来按 targetId 分组,理论上群 ID 和用户 ID 相同时会混在一起;现在改为按"类型 + line + target"分组,保证 gap 里的会话信息准确。
五、客户端:两种存储模型,两种补法
四个客户端的本地存储其实分成两类,补法也不一样。
1. Web 与 PC:滑动窗口,丢掉就好
Web(Vue 3)和 PC(Electron)在本地只缓存每个会话最近 50 条,往上翻时本来就是直接用最老一条的 uid 去拉服务端。
所以它们不需要记录断层:收到 gap 时,把这个会话里断层以下的缓存消息丢掉,只留下新拉到的连续一段。之后往上翻,最老一条就是断层处,LRM 自然从这里往前拉,空洞就补上了。
需要注意的细节只有两个:uid 是字符串形式的 64 位整数,比较时必须转 BigInt,不能直接用 <,也不能按字符串比;未确认送达的消息(uid 为 0)和 AI 流式回复的占位不能误删。
2. iOS 与 Android:完整本地库,要记住缺口
移动端把所有消息都存在本地数据库里,丢掉老消息就等于删用户的聊天记录,不能这么做。因此需要真正"记住"缺口:
- 记录断层:收到 gap 时写入一张断层表。只有本地确实存在比
before_uid更早的消息时才记录,因为本地没有更早消息,就不存在空洞,现有的"本地读完再拉远程"已经能处理。 - 分页时不跨越断层:会话页只显示"最高那个断层"以上的消息。这里按 uid 范围过滤,而不是"找到 uid 等于
before_uid的那条消息就截断":补拉回来的一页里,最老的一条可能是通话信令这类不落库的消息,按锚点匹配会找不到。 - 翻到断层时补拉:用
LRM(beforeUid = 断层)拉一页,落库后:- 如果这一页里有消息的 uid 不超过"断层下方本地最新的一条",说明已经接上,删除断层;
- 如果这一页不满(服务端已经到底),也删除断层;
- 否则把断层下移到这一页最老的一条,下次接着补。
- 尾部断层:打开会话(iOS)或收到 gap(Android)时立即补拉最新一页,补完后它就变成一个普通断层。
第 3 步里判断"接上了"用的是 uid 比较,而不是"返回的某条消息本地已经有了"。这样即使用户在本地删过消息,补拉也能正确收尾,被删的消息也不会被重新插回来。
3. Android 的额外一步:远程历史统一落库
Android 原来有一个特点:往上翻拉到的远程历史只交给界面显示,不存本地库。这在以前没什么问题,但和断层补拉放在一起就出现了矛盾:Android 的翻页游标是界面最上面那条消息的本地 ID,下一页要先去本地库查它对应的 uid。补拉回来的消息如果不落库,断层接上之后,游标在库里查不到,接下来读本地老消息的位置就不可靠了。
所以这次把 Android 的远程历史统一改成落库:补断层拉到的、普通往上翻拉到的,都按 uid 去重后存进本地。顺带的好处是,下次打开会话往上翻,不用再重复从服务端拉同一批消息。
六、怎样尽量不影响现有用户
这次改动横跨协议、服务端和四个客户端,最需要小心的是"已经在用的人"。我们逐一检查了几类风险。
1. 新旧版本混跑
- 旧客户端 + 新服务端:proto2 新增的 repeated 字段会被旧客户端忽略,JSON 多出的
gapList也一样。下发规则没变,所以旧客户端的行为和以前完全一致:不会更好,但也绝不会更差。 - 新客户端 + 旧服务端:收不到 gap,就当作没有断层,行为和升级前一致。
- 因此发布顺序是先服务端、后客户端,任何一个时间点都不会出现比现在更糟的状态。
- 服务端内部有一点需要注意:
push-group与connector之间的 Dubbo 传输模型加了字段,两者要同时发布。
2. 上线这条高频路径保持不变
每会话 20 条、3MB 的规则原样保留,用户每天上线时的流量和首屏速度不受影响。补拉只在用户主动往上翻到缺口时才发生。
3. 不碰用户已有的数据
- Android 不升数据库版本:现有的
onUpgrade会删掉全部表再重建,升版本等于清空所有人的本地聊天记录。断层表改为在打开数据库时CREATE TABLE IF NOT EXISTS创建。 - iOS 走正常的 GRDB 迁移,只新增一张表。
- 补拉得到的消息走"历史消息"的插入路径:不增加未读数、不弹通知、不改会话列表里的最后一条消息、不复活用户删过的消息。尾部断层补的是最新一段,是唯一会更新会话最后一条消息的情况。
4. 避免一闪而过的错乱
Android 处理增量拉取时,落库过程中就会回调界面刷新。如果先落库消息、后记断层,界面会有一瞬间把空洞两侧的消息拼在一起显示。所以顺序固定为先记断层,再落库消息。iOS 把消息、断层和同步位置放在同一个数据库事务里提交,天然没有这个问题。
5. 失败可以重试
补拉请求失败(超时、服务端报错)时,断层原样保留,下次往上翻会重新尝试,不会因为一次网络抖动就误判"历史已经到底"。
七、已知限制
- 已经丢失的消息补不回来:这次上线之前形成的空洞没有任何记录,新机制无从发现。如果确实需要,可以清空本地该会话后从服务端重新加载。
- 断层内的消息补拉前搜不到:它们还不在本地,本地搜索自然搜不到。
- 补拉最多回溯 12 个月:这是服务端按月分表查询本身的上限。
- 尾部断层的会话预览:iOS、Web、PC 补完尾部断层后,会话列表里的最后一条消息要等下一条新消息到达才刷新。这种情况只在单次拉取超过 3MB 时出现,实际很少遇到。
八、对应版本
| 端 | 版本 |
|---|---|
| 服务端 | 2.2.14-SNAPSHOT |
| Android | 2.0.20 |
| iOS | 2.0.19 |
| Web | 1.3.1 |
| PC 桌面端 | 1.8.1 |
断层补拉需要服务端 2.2.14 及以上;客户端在旧服务端上运行时行为与升级前一致。完整设计文档见 chat-server-pro 仓库的 docs/superpowers/specs/2026-10-26-conversation-gap-sync-design.md。
回头看,这个问题的根源并不复杂:一条为首次登录设计的限制,在增量同步里悄悄生效了,而且截掉的东西没有留下任何痕迹。修复它真正花功夫的地方不在算法,而在于:判断该让服务端多做什么、让客户端多做什么;以及在协议、四个客户端和用户已有数据之间,确保每一步都不会让现在的情况变得更糟。