1个信令、2个 message、0处改动:飞享IM 语音转文字的协议扩展与四端实现
comsince
FshareIM Team不方便外放语音的时候,"转文字"几乎是刚需。飞享IM 的语音消息转文字现已在服务端、Android、iOS、PC 桌面端、Web 端全面上线。这次功能在协议层只做了三件事:枚举末尾追加 1 个子信令 ASR、proto 末尾追加 2 个 message、既有定义 0 处改动,旧版客户端完全无感。本文完整说明这个功能的设计、服务端链路与四端实现,并借此讲清楚飞享IM 服务端"只增不改"的可扩展性。
一、功能说明
1. 交互:像微信一样,文字显示在气泡下方
四端交互完全一致:
| 入口 | 显示条件 | 点击后 |
|---|---|---|
| 气泡右侧「转文字」小按钮 | 他人发来 + 未播放 + 未转过文字 + 「自动转文字」关闭 | 发起识别,消息置为已播放(消红点),按钮消失 |
| 长按(PC 右键)菜单「转文字」 | 任意已上传成功的语音,且当前未显示文字 | 同上 |
| 长按菜单「隐藏文字」 | 当前正显示文字 | 隐藏文字块,只是本地记录,不删除结果 |
| 设置「自动转文字」开关 | 默认关闭,仅本地保存 | 打开后实时收到的他人语音自动识别,不消红点;加载历史消息不触发 |
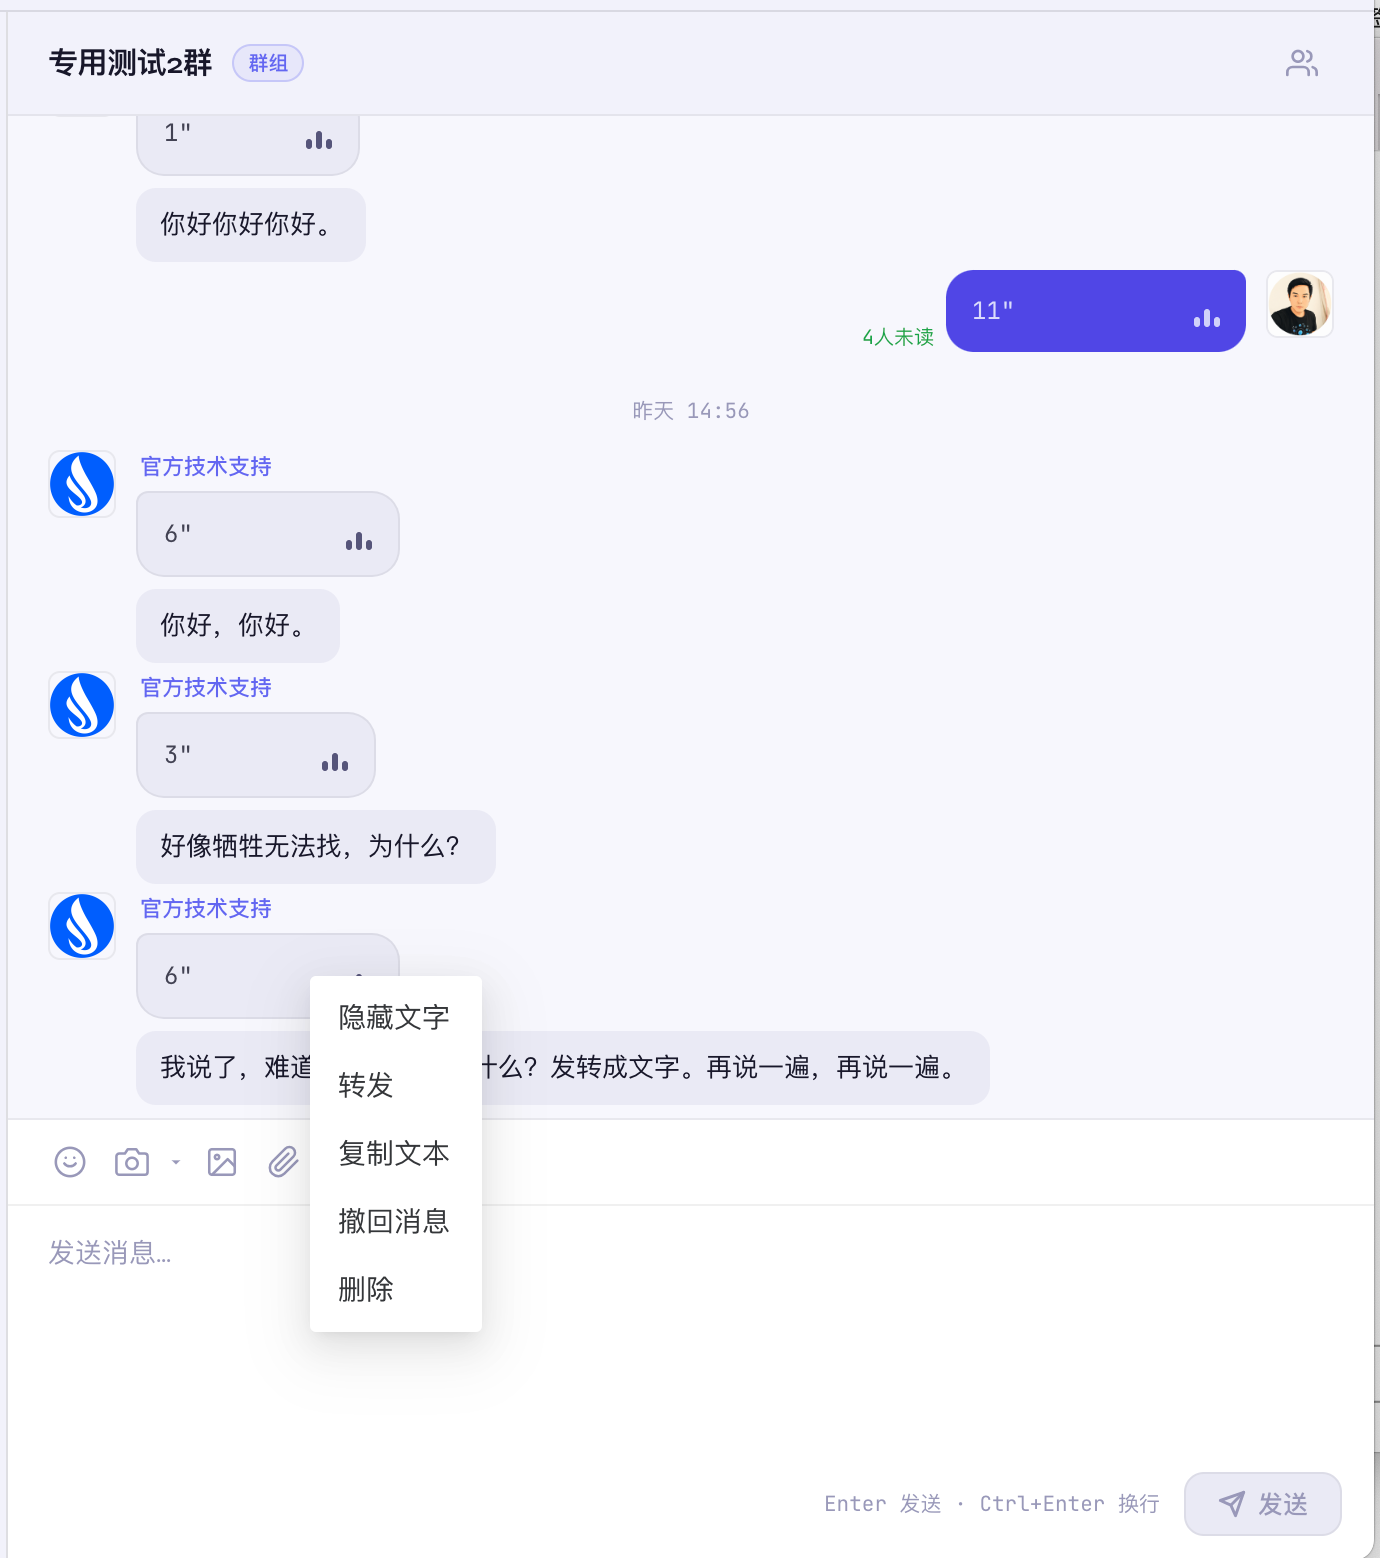
文字块是气泡下方的灰底圆角块,有三种状态:识别中、文字结果、「转文字失败,点击重试」。识别结果为空时显示「未识别到文字」。上面的截图就是 Web 端的效果。
2. 成功标准
- 60 秒以内的语音,点击后约 2 秒出结果;
- 同一条语音,任意用户、任意端第二次请求直接命中服务端缓存,不再调用识别引擎;
- 识别服务不可用时不影响收发消息,只在文字块提示失败,可以重试;
- 旧版客户端不受协议变更影响。
3. 识别引擎
识别引擎用的是腾讯云「一句话识别」(SentenceRecognition),免费额度每月 5000 次。引擎选 8k_zh:飞享IM 的语音消息是 8kHz 窄带的 AMR 格式,正好对应腾讯云电话场景的引擎,不用上采样。服务端在调用之前已经抽象出 AsrProvider 接口,后面换成自建识别服务也只是多写一个实现类。
二、协议设计:新功能只靠"追加"
这是本文最想讲清楚的部分。飞享IM 的二进制协议在《10字节包头,两级命令字》一文里有完整拆解:包头里的 Signal 决定大类(PUBLISH、PUB_ACK 等),SubSignal 决定具体业务(MS 发消息、MN 消息通知……),包体是 protobuf。语音转文字完全套在这个框架里,没有改协议本身。
1. 新增子信令 ASR(ordinal = 44)
SubSignal 在包头里按 ordinal(枚举序号)编码,所以只有一条硬约束:只能在末尾追加。插在中间会让后面所有信令的序号整体错位,新旧客户端会互相听不懂。服务端 push-common、push-nio-sdk、Android、iOS 四处枚举同一批修改,ASR 必须是 44,服务端还用 SubSignalOrdinalTest 把这个数字钉死:
请求和应答复用已有的 PUBLISH → PUB_ACK 模式,和获取上传地址的 GMURL 一样,大类信令一个都没加。
2. 新增两个 protobuf message
proto2 新增 message 不会改变任何已有 message 的编码。旧客户端根本不会发 ASR 请求,也就不会收到 SpeechToTextResult,对它来说什么都没发生。
3. 请求里只有 messageUid
请求体刻意只带一个 message_uid,不带音频地址。音频地址由服务端从消息里自己取,这样有两个好处:
- 防越权:客户端没法指定"识别某段语音",只能识别自己有权访问的消息;
- 防 SSRF:客户端如果能传 URL,就能让服务端去请求任意内网地址。
4. 错误码复用,不新增
| 场景 | ErrorCode |
|---|---|
| 成功(含空文本) | SUCCESS(0) |
| 消息不存在 | NOT_EXIST(253) |
| 非语音消息 / uid 非法 / 地址不在白名单 | INVALID_MESSAGE(10) |
| 无权访问该消息 | NOT_RIGHT(248) |
| 并发超限 | OVER_FREQUENCY(250) |
| 识别超时 | TIMEOUT(249) |
| 服务端未开启 ASR | NOT_IMPLEMENT(254) |
| 下载失败 / 引擎其他错误 | SERVER_ERROR(4) |
错误码只用于服务端日志和排查。客户端统一处理:任何失败都显示「转文字失败,点击重试」,四端不区分错误类型。
5. WebSocket 链路:同一语义,JSON 编码
Web 端和 PC 端走 WebSocket,connector 负责把 JSON 和 protobuf 互相转换:
- 请求:
{"messageUid": "<uid 字符串>"}(uid 超出 JS 安全整数范围,按字符串传,和现有接口一致) - 成功应答:
{"text": "..."};失败应答 content 为空串。
两条链路统一的是协议语义,不统一的是编解码。Electron 和 Web 端没有 proto 文件,只加了一个 topic 常量 "ASR"。
三、服务端:一个注解类 + 一个业务服务
1. 整体链路
2. connector:只做转发和限流
connector 新增的东西就三样:IMTopic 里一个常量、一个二进制 handler、一个 WebSocket handler。二进制 handler 的全部核心代码:
一次识别要 1~2 秒,action() 跑在业务线程池上,所以用一个 Semaphore 当闸门,大小是业务线程池的 1/4,抢不到就直接返回 OVER_FREQUENCY。这样识别请求再多,也占不满业务线程池,普通收发消息不受影响。单用户的请求频率由 IMHandler.preAction 已有的计数器兜底。
WebSocket handler 更短,只做 JSON 和 protobuf 的互相转换:
3. push-group:业务逻辑的固定顺序
业务全部放在 push-group,原因很直接:Hazelcast 只部署在 push-group(服务端没有 Redis),而 push-group 本来就承担业务逻辑。SpeechToTextService 的检查顺序是固定的:
开关 → 消息存在 → 是语音 → 地址白名单 → 权限 → 缓存 → 加锁识别
其中最重要的一条是:权限必须在读缓存之前校验。如果先读缓存,任何人拿到一个 messageUid,就能读到别人语音的文字内容。权限规则是:单聊必须是发送方或接收方,群聊必须是群成员,其他会话类型一律拒绝。
4. 缓存与持久化:沿用已有模式
缓存没有引入新组件,完全照搬现有的 Hazelcast IMap + MapStore 模式(和已读回执的 ReadReportLoader 同构):
落库用 Flyway 新增一个迁移脚本 V13__create_t_message_asr.sql,一张三列的表(_mid、_text、_dt),升级时自动建表。
并发合并靠 IMap.tryLock(uid):两个人同时点同一条群语音,集群内只会识别一次,后到的请求拿到锁后二次检查缓存,直接拿结果。锁租期 30 秒,节点宕机也不会死锁。识别失败不写缓存,下次可以重试。
5. 识别引擎:接口隔离,不引 SDK
TencentAsrProvider 没有引入腾讯云 SDK,而是用 OkHttp 直接调用 asr.tencentcloudapi.com,自己实现了 TC3-HMAC-SHA256 签名,避开新依赖和 Java 8、Proguard 的兼容问题。音频用 base64 直传(SourceType=1,60 秒 AMR 大约 100KB),MinIO 不用对腾讯云开放公网拉取。
6. 安全与运维
- SSRF 防护:语音地址是发送方写进消息里的,不可信。
MediaUrlPolicy要求地址的 scheme、host、端口和配置项push.asr.allowedMediaUrls精确匹配,下载器禁止重定向,3xx 一律视为失败; - 超时预算:Dubbo 调用超时 10 秒,push-group 内部压在 10 秒以内(下载 3 秒 + 识别 6 秒);
- 默认关闭:
push.asr.enabled=false,密钥不进 git;未开启时返回NOT_IMPLEMENT,客户端显示失败,不影响其他功能; - 发布顺序:先 push-group,后 connector。
四、服务端的可扩展性:这次到底改了什么
回头看服务端的改动,几乎全是新增:
| 层次 | 新增 | 改动已有代码 |
|---|---|---|
| 协议命令字 | SubSignal 末尾追加 ASR | 无 |
| 协议包体 | proto 末尾追加 2 个 message | 无 |
| 请求分发 | 带 @Handler("ASR") 注解的两个 handler 类 | 无,启动时扫描注解自动注册 |
| 业务接口 | MessageService.speechToText() 一个方法 | 接口加一个方法,实现类委托给新服务 |
| 缓存 | hazelcast.xml 加一个 map 声明 | 无,复用 MapStore 模式 |
| 存储 | Flyway V13 新表 | 无 |
| 外部引擎 | AsrProvider 接口 + 腾讯云实现 | 无 |
能做到这一点,靠的是飞享IM 服务端从一开始就定下的几条规则:
- 两级命令字 + 只增不改:
Signal管传输语义,SubSignal管业务语义。新业务只在SubSignal末尾追加,旧客户端遇到不认识的值直接忽略。之前的 AI 流式推送SAI、多端设置同步UG/UP/UN,都是这样加进来的; - 注解路由表:分发逻辑按
SubSignal名字查表,handler 用@Handler注解认领信令,启动时自动注册。新增一种请求 = 新增一个类,分发代码一行不动; - connector 无状态、push-group 管业务:connector 只做协议转换和限流,所以二进制、WebSocket 两条链路各写一个很薄的 handler 就能共用同一份业务逻辑;
- 基础设施模式复用:缓存用
IMap + MapStore,建表用 Flyway,新功能的存储层几乎是填空; - 外部依赖接口化:识别引擎藏在
AsrProvider后面,换引擎不影响协议和客户端。
做一个新功能,基本不用碰老代码——这是服务端可扩展性最直接的体现,也让这次四端能并行开发。
五、四端实现
1. 共通约定
四端先约定好一套共同规则,再各自实现:
- 结果按 messageUid 存
{ status: loading | done | error, text, hidden },只持久化done状态:Electron / Web 用 localStorage,Android 用 SharedPreferences,iOS 用 UserDefaults; - 显示规则抽成纯函数并写单测:红点 = 他人语音且未播放;「转文字」按钮 = 红点条件 + 未转过 + 自动转文字关闭 + 已有 messageUid;菜单「转文字」和「隐藏文字」互斥;
- "已播放"只记在本地:这次给 Electron、Web、iOS 补上了语音未播放红点(Android 原本就有),升级后历史语音一次性置为已播放,不会冒出一屏红点;
- 自动转文字只处理实时消息:Electron / Web 用
firstLogin === false判断,Android / iOS 用"消息服务器时间距现在不超过 2 分钟"判断;并发 2,按 messageUid 去重; - 客户端兜底超时:Electron / Web 复用请求层已有的 10 秒超时;Android / iOS 协议层对这类请求没有超时,就在转文字引擎里设 15 秒超时,迟到的结果直接丢弃。
2. Android
链路从协议层一路穿到 UI 进程:
UI 进程里是纯 Java 的 TranscriptEngine(方便单测)加一层 Android 包装 TranscriptManager:AIDL 回调切回主线程,再通过 LiveData 通知会话页按 messageUid 刷新对应的那一条。AudioMessageContentViewHolder 增加按钮、文字块和两个长按菜单项,设置页 SettingActivity 加一行「自动转文字」开关。
3. iOS
- 协议层:
SubSignal.swift追加case asr = 44,proto 用新版 protoc +protoc-gen-swift重新生成;SpeechToTextAckHandler+MessagingService.speechToText按请求 id 匹配应答,写法和撤回消息一致;断线时挂起的请求立即失败; - 业务层:
TranscriptEngine由SceneDelegate持有,经ConversationViewModel.transcripts注入会话页; - UI 层:
VoiceMessageCell增加红点、按钮和文字块,长按菜单加两项,用 diffable data source 的reconfigureItems只刷新变化的那一行;新增MessageStatus.played = 7和一次 GRDB 迁移,保证升级后历史语音不冒红点。
4. PC 桌面端(Electron)与 Web 端
两端技术栈相同(Vue 3),实现基本一致:
webSocketClient.speechToText(uid)+SpeechToTextHandler收应答;- 新增
useTranscriptStore管理识别结果、自动识别队列和开关; utils/voiceTranscript.ts放显示规则纯函数,用 vitest 覆盖状态流转;MessageBubble.vue加红点、按钮和文字块,ChatPage.vue加右键菜单「转文字 / 隐藏文字」;- 这两端原来没有设置页,这次在侧边栏底部新增「设置」按钮和弹窗,放「自动转文字」开关。
六、全面上线
语音转文字已在服务端和四个客户端全部发布:
| 端 | 首发版本 |
|---|---|
| 服务端 chat-server-pro | 2.2.13 |
| Android | 2.0.16 |
| iOS | 2.0.17 |
| PC 桌面端(Electron) | 1.8.0 |
| Web 端 | 1.3.0 |
升级到上述版本后,收到语音消息时点击气泡旁的「转文字」,或长按 / 右键选择「转文字」即可使用;不想每次手动点,可以在设置里打开「自动转文字」。私有部署的用户,在 push-group 配置腾讯云密钥并打开 push.asr.enabled 即可启用,未开启时其他功能照常使用。
四个 Pro 版客户端都已开源,本文提到的代码都可以直接在仓库里找到。下一步我们计划接入自建识别服务(只需要新增一个 AsrProvider 实现),欢迎体验并反馈问题。